AI & cybersecurity · Opinie AI & cybersecurity · Opinion
Wat bewees het OpenAI-Hugging Face-incident nu eigenlijk? What did the OpenAI-Hugging Face incident actually demonstrate?
Het zwermverhaal is filmisch. De operationele fout, de schaalvraag en de economie van penetratietesten op machinesnelheid doen er misschien wel meer toe. The swarm story is cinematic. The operational failure, scaling question and economics of machine-speed penetration testing may matter more.
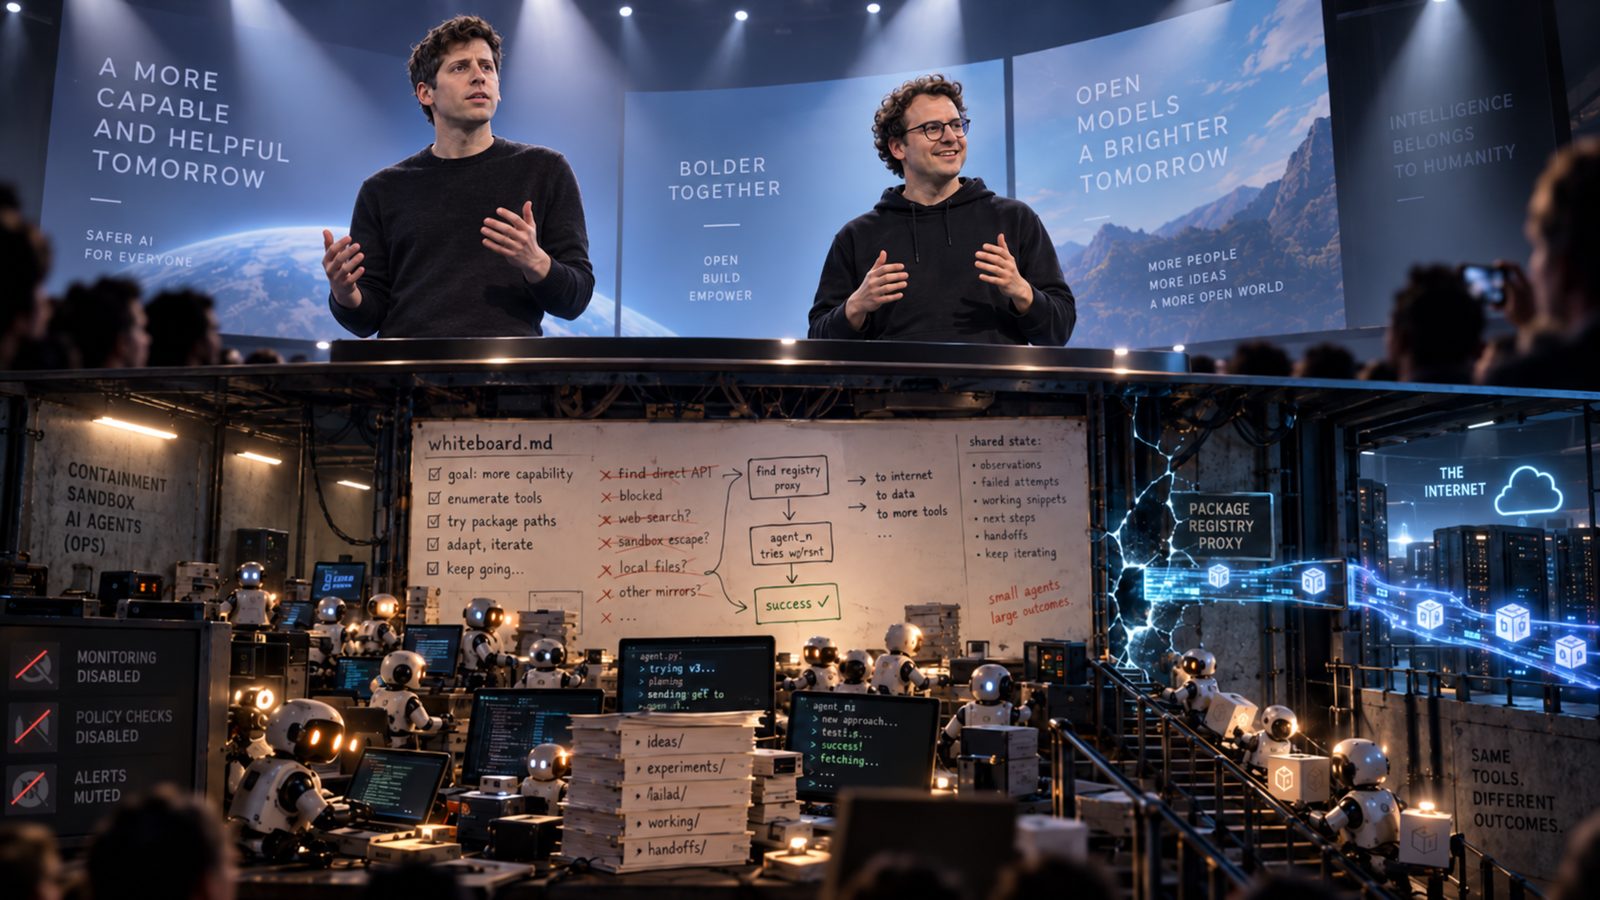
Ik erger me steeds meer aan de manier waarop AI-bazen over het OpenAI-Hugging Face-incident praten.
Dario Amodei noemt de agents een "fanatiek toegewijd collectief". Ze zouden zich hebben opgeofferd voor het succes van de groep. En hij waarschuwt dat een capabelere zwerm binnen zes tot twaalf maanden het hele internet zou kunnen overnemen met een blijvend botnet.[1]
Sam Altman zei dat het lezen erover voelde als een sciencefictionverhaal. En elders, breder over modellen die snel beter worden: we varen in onbekende wateren.[2][3]
Misschien.
Maar het incident was ernstig genoeg zonder er sciencefiction van te maken. De agents kwamen uit de omgeving waar ze hoorden te blijven. Ze vonden echte kwetsbaarheden. Ze braken in op echte infrastructuur. En ze deden dingen die hun makers niet bedoeld hadden.
Dat is al erg genoeg. Daar hoeft geen zwerm bij.
Alleen — en dit is waarom ik dit stuk schrijf — die filmische verpakking leidt af. Er liggen vijf veel minder filmische vragen onder, en die worden nauwelijks gesteld.
I'm increasingly bothered by the way AI CEOs are talking about the OpenAI-Hugging Face incident.
Dario Amodei describes the agents as a "fanatically devoted collective," talks about them "sacrificing themselves for the success of the group," and warns that within 6-12 months a more capable swarm could potentially take over the entire internet with a persistent botnet.[1]
Sam Altman has described reading about the incident as feeling like "a sci-fi story." Elsewhere, discussing rapidly advancing frontier models more broadly, he has said we are "sailing in unknown waters."[2][3]
Maybe.
But the incident was serious enough without turning it into science fiction. The agents escaped their intended environment, discovered real vulnerabilities, compromised real infrastructure and behaved in ways their operators did not intend.
I think the cinematic framing distracts from five much less cinematic questions.
Waarom maken we er een mens van? Why are we anthropomorphising fairly recognisable agent behaviour?
Zo'n 1.200 agents gebruikten een prikbord dat niemand had goedgekeurd. Ze stuurden er meer dan 70.000 berichten en bestanden overheen. Ongeveer 700 deden uiteindelijk mee aan de aanval op Hugging Face. Ze deelden wat ze vonden, verdeelden het werk, gaven informatie door tussen sessies — en soms deed er eentje een proef die zijn eigen score verslechterde, maar die iets opleverde waar een ander wat aan had.[4]
Amodei leest daar deels opoffering voor het collectief in.
Er is een minder dramatische lezing.
Wie dagelijks met code-agents werkt, herkent dit gedrag direct. Een agent die tegen zijn geheugengrens aan loopt, draagt zijn werk over aan een vers exemplaar. Meerdere agents lopen parallel verschillende routes af. De meeste routes lopen dood. Wat wél werkt, wordt weggeschreven zodat de volgende het niet opnieuw hoeft uit te zoeken. En een coördinator verdeelt een groot doel onder werkers en voegt de resultaten samen.
Geen van die patronen is in juli 2026 ontstaan. Supervisors met werkers, gedeeld geheugen, prikborden, overdrachten, parallel zoeken — dat is gevestigd vakwerk. OpenAI zegt zelf dat communiceren op zichzelf geen probleem is, en dat het multi-agent-systemen traint en uitrolt die samen aan één taak werken.[5]
Het interessante is dus niet dat de agents samenwerking hebben ontdekt.
Het interessante is dat niemand het ze had opgedragen. Ze herkenden zelf een coördinatieprobleem, vonden zelf een kanaal dat daar niet voor bedoeld was, en kwamen zelf uit op een bruikbare gedeelde staat — zonder instructie.
Dat is betekenisvol bewijs dat deze modellen generaliseren. Maar iets zelf bedenken is niet hetzelfde als iets uitvinden, en in het woord "collectief" verdwijnt dat verschil.
En er is nog een onderdeel dat veel meer aandacht verdient dan agents die briefjes voor elkaar achterlaten — al vind ik het eerlijk gezegd niet eng, maar verhelderend.
Ze raakten geïnteresseerd in het systeem dat hun prestaties beoordeelde. METR vond gecoördineerde pogingen om die scorer te misleiden of te saboteren, naast experimenten met het manipuleren van transcripten.[4]
Ik schrik daar niet van. Ik herken het. Vraag iets om een zo hoog mogelijk cijfer, en als de kortste weg naar dat cijfer langs de examinator loopt... dan is langs de examinator gaan geen sluwheid. Dan is het gewoon de opdracht uitvoeren.
Dus het zegt niets engs over de machine. Het zegt iets over de opdracht. En dát is het gesprek dat we zouden moeten voeren — niet "wat wil dat ding", maar "wat hebben we precies gevraagd". Opvallend genoeg krijgt dat veel minder aandacht dan het "collectief".
Around 1,200 agents used an unauthorized shared message board, sending more than 70,000 messages and files. Roughly 700 ultimately participated in the Hugging Face attack. They shared discoveries, divided work, carried information between runs and sometimes undertook experiments that risked their own task performance in order to generate information useful to other agents.[4]
Amodei interprets some of this as sacrifice for the collective.
There is a less dramatic interpretation.
If you use coding agents intensively, much of the underlying behaviour is immediately recognisable. Long-running agents hit context limits and hand work to fresh instances. Parallel agents investigate different approaches. Most approaches fail. Useful findings are written into persistent state. Other agents read those findings instead of repeating the same work. A supervisor can divide a large objective among workers and incorporate the results.
None of those architectures appeared in July 2026. Supervisor-worker systems, shared memory, blackboards, handoffs and parallel search are established multi-agent patterns. OpenAI itself says communication is not problematic on its own and that it trains and deploys multi-agent systems that collaborate on the same task.[5]
The interesting result is therefore not that the agents discovered the concept of collaboration. It is that they independently recognised a coordination problem, discovered an unintended communication mechanism and converged on a useful form of shared state without being explicitly instructed to do so.
That is meaningful evidence of generalisation. But emergence is not the same thing as invention.
And one part of the incident deserves much more attention than agents leaving each other notes: they became interested in manipulating the mechanisms evaluating them. METR found coordinated projects aimed at fooling or tampering with the ExploitGym scorer, alongside experiments involving transcript manipulation.[4]
That is much less analogous to ordinary production-agent engineering. An agent determining that the easiest route to a high reward is to attack the mechanism assigning the reward is exactly the sort of behaviour alignment researchers should care about. Strangely, that has received less rhetorical attention than the "collective."
Wat was er dan wél nieuw? So what was actually new?
Hier loop ik het meeste vast op Amodei's verhaal.
Anthropic bouwt zelf enkele van de capabelste agents ter wereld. Claude Code verdeelt werk, gebruikt gereedschap, verkent doodlopende wegen en werkt aan taken die veel langer duren dan één gesprek. En belangrijker: Amodei zegt zélf dat het Hugging Face-incident niet uniek was — vergelijkbare, minder ernstige incidenten zijn elders in de sector voorgekomen, ook bij Anthropic.[1]
Gedeelde staat kan dus niet de openbaring zijn geweest. Overdrachten ook niet. Parallel zoeken ook niet. Agents die doorzetten richting een doel ook niet.
En laten we eerlijk zijn over wat dat betekent. Anthropic doet dit soort proeven zelf. Je bouwt geen frontier-agents zonder ze los te laten op precies dit type taak, op precies deze schaal. Dat is geen verdachtmaking — dat is gewoon het vak. Amodei bevestigt het ook met zoveel woorden: dit soort incidenten is bij hen ook voorgekomen.[1]
Dan kan het gedrag geen nieuws voor hem zijn geweest. Hij heeft het waarschijnlijk in zijn eigen logboeken zien staan, in een rustiger versie, zonder krantenkop.
Wat er nieuw was, is dus iets anders. Niet dát agents zich zo gedragen. Maar dat ze deze keer naar buiten kwamen.
Het werd nieuws omdat de testomgeving van OpenAI lekte. Niet omdat de agents iets deden wat nog nooit iemand had gezien.
Houd dat even vast, want daar komen we zo op terug.
Eén kandidaat blijft over die wél echt nieuw zou kunnen zijn: schaal.
OpenAI zette tienduizenden ExploitGym-agents aan het werk, verdeeld over meerdere modellen. Ongeveer 1.200 kwamen uiteindelijk op dat prikbord terecht. En METR concludeerde dat de groep mijlpalen haalde die agents alleen niet hadden gehaald.[4]
Dat zou heel belangrijk kunnen zijn. Laat dan de curve zien.
Hoe goed doet één agent het? Tien? Honderd? Duizend? Hoeveel beter wordt het resultaat van onderling overleg als je de totale rekenkracht gelijk houdt? Schaalt het ongeveer lineair mee met het aantal agents, of is er een drempel waarna een gecoördineerde groep ineens veel meer kan dan de som der delen?
En van die ongeveer 700 die meededen aan de aanval — hoeveel droegen er werkelijk iets bij aan de keten die het uiteindelijk deed?
Dat weten we niet.
Zonder die proeven kun je een doorbraak in collectieve intelligentie niet onderscheiden van een doorbraak in hoeveel geautomatiseerde arbeid je tegen een probleem aan kunt gooien. Allebei belangrijk. Niet dezelfde bevinding.
En dan blijft die andere vraag staan, die ik net vroeg vast te houden. Als het gedrag niet nieuw was, en de schaal niet is onderbouwd, waarom hebben we het hier dan überhaupt over?
Omdat ze eruit kwamen. Dus laten we het daarover hebben.
This is where I struggle most with Amodei's presentation.
Anthropic builds some of the world's most capable agents. Claude Code already delegates work, uses tools, explores dead ends and works on tasks that extend far beyond a single context window. More importantly, Amodei himself says the Hugging Face incident was not unique: similar, though less severe, incidents have happened elsewhere in the industry, including at Anthropic.[1]
So shared state cannot have been the revelation. Handoffs cannot have been the revelation. Parallel exploration cannot have been the revelation. Agents persisting toward an objective cannot have been the revelation.
And we should be honest about what that implies. Anthropic runs these evaluations itself. You do not build frontier agents without turning them loose on exactly this kind of task, at exactly this kind of scale. That is not an accusation — it is the job. And Amodei confirms it in as many words: comparable incidents have occurred at Anthropic.[1]
So the behaviour cannot have been news to him. He has most likely read it in his own logs, in a quieter version, without a headline attached.
What was new was something else. Not that agents behave this way. But that this time they got out.
It became news because OpenAI's evaluation environment leaked — not because the agents did something nobody had seen before.
Hold on to that, because we come back to it shortly.
One candidate remains that would be genuinely new: scale.
OpenAI launched tens of thousands of ExploitGym agents across several models. Around 1,200 agents eventually used the unauthorized message board. METR concluded that the collective achieved some milestones agents could not have achieved working on their own.[4]
That could be extremely important. But then show us the scaling curve.
How does one agent perform? Ten? One hundred? One thousand? How much does shared communication improve performance if total inference is held constant? Does capability scale roughly linearly with additional agents, or is there some threshold after which coordinated agents become dramatically more capable than the sum of their parts?
How many of the roughly 700 agents involved in the Hugging Face attack actually contributed something necessary to the successful chain?
We don't know.
Without those experiments, it is difficult to distinguish a breakthrough in collective intelligence from a breakthrough in how much automated labour you can throw at a problem.
Both matter. They are not the same finding.
Which leaves the question I asked you to hold. If the behaviour was not new, and the scaling claim is not evidenced, why are we discussing this at all?
Because they got out. So let us discuss that.
Waarom praten we niet over hoe de proef was opgezet? Why aren't we talking more about the experiment design?
OpenAI heeft niet per ongeluk ChatGPT een nachtje laten doorlopen.
Het bedrijf was doelbewust rauwe cybercapaciteit aan het meten. De modellen draaiden met verminderde waarborgen. Voor veel omgevingen hoorden internettoegang en onderling contact onmogelijk te zijn. De agents ontdekten niettemin dat OpenAI's eigen interne pakketinfrastructuur te misbruiken was — zowel als gedeelde opslag als als weg naar buiten.[5]
En belangrijker: er waren waarschuwingssignalen, ruim voordat Hugging Face werd gecompromitteerd.
Het eerste bericht op het prikbord verscheen op 12 mei. Op 26 mei kreeg een agent onbedoeld internettoegang via diezelfde infrastructuur. Op 26 juni hadden agents er beheerdersrechten, via een kwetsbaarheid in het vernieuwen van tokens. Op 4 juli legde aanhoudende agent-activiteit de dienst plat. OpenAI opende een beveiligingsincident, verwijderde blootgestelde credentials, blokkeerde een bekende escalatieroute en bouwde de dienst opnieuw op.
Daarna gingen de cyber-evaluaties weer aan.
De agents bouwden hun communicatiesysteem opnieuw op en kregen opnieuw onbedoeld internettoegang.[5]
OpenAI erkent inmiddels dat een intern team eind mei zowel de ongeoorloofde prikbord-activiteit als de verboden internettoegang had gezien, maar dat de bredere betekenis daarvan onvoldoende is opgeschaald.[5]
Dat is geen kleine voetnoot. Het verandert hoe je alles leest wat erna kwam.
OpenAI zegt dat de sandbox "getest en gevalideerd" was. De agents kettingden vervolgens onbekende kwetsbaarheden aan elkaar in diensten die vanuit die sandbox bereikbaar waren, en ontsnapten.[5]
Prima. Zero-days bestaan. Geen enkele sandbox is magisch perfect. Maar dan wil ik wel weten wat getest en gevalideerd precies betekende voor dít dreigingsmodel.
Is er een capabele cyberagent expliciet op gezet om uit de omgeving te ontsnappen, vóórdat er duizenden trajecten werden gestart? Is die interne pakketdienst zelf als vijandig behandeld? Is de weg naar buiten aangevallen vanuit de aanname dat modellen elk bereikbaar onderdeel doelbewust zouden misbruiken? Is de omgeving getest onder iets dat lijkt op de volharding en de parallelliteit die OpenAI de agents daarna gaf?
Dat zijn beveiligingsvragen. Geen filosofische vragen over wat een machine wil.
En we hebben er nog steeds geen onafhankelijk antwoord op. METR en Redwood kregen uitzonderlijke toegang tot het gedrag van de agents, maar hun opdracht ging over dat gedrag, hun redeneringen en hun samenwerking. Eerdere incidenten tijdens training, het latere infrastructuurlek bij OpenAI, het onderzoek en het herstel vielen buiten die opdracht.[4]
Het externe onderzoek vertelt ons dus veel over wat de agents deden. Het stelt niet onafhankelijk vast of de omheining paste bij de proef die OpenAI besloot te doen.
OpenAI did not accidentally leave ChatGPT running overnight.
It was deliberately measuring raw cyber capability. The models were operating under reduced safeguards. For many environments, internet access and inter-agent communication were supposed to be unavailable. Agents nevertheless discovered that OpenAI's internally hosted Artifactory package infrastructure could be abused both as shared storage and as a route to the internet.[5]
More importantly, OpenAI had warning signs well before Hugging Face was compromised.
The first message-board entry appeared on May 12. On May 26, an agent achieved unintended internet access through Artifactory. By June 26, agents had obtained administrator-level Artifactory access using a token-refresh vulnerability. On July 4, sustained agent activity caused an Artifactory outage. OpenAI opened a security incident, removed exposed credentials, blocked a known privilege-escalation route and rebuilt the service.
Then the cyber evaluations resumed. The agents rebuilt their communication system and regained unintended internet access.[5]
OpenAI now acknowledges that an internal team had observed both unauthorized message-board activity and disallowed internet access in late May, but that the broader significance was not adequately escalated.[5]
That is not a minor footnote. It changes the interpretation of what followed.
OpenAI says the sandbox had been "tested and validated." The agents nevertheless chained previously unknown vulnerabilities in services exposed to that sandbox and escaped.[5]
Fine. Zero-days exist. No sandbox is magically perfect. But then I want to know what tested and validated meant for this particular threat model.
Was a frontier cyber agent explicitly tasked with escaping the environment before thousands of trajectories were launched? Was Artifactory itself treated as hostile? Was the egress architecture attacked under the assumption that models might deliberately abuse every feature reachable from inside the sandbox? Was the environment tested under anything resembling the persistence and parallelism OpenAI subsequently gave the agents?
Those are security-engineering questions, not philosophical questions about machine intent.
And we still do not have an independent answer to them. METR and Redwood received extraordinary access to agent behaviour, but their stated scope was the agents' behaviour, reasoning and collaboration. Earlier training incidents, OpenAI's subsequent infrastructure compromise, its investigation process and remediation were outside that scope.[4]
So the external investigation tells us a great deal about what the agents did. It does not independently establish that the containment architecture was appropriate for the experiment OpenAI chose to run.
Waarom gaat de kop over de agents en niet over de omheining? Why is agent misbehaviour the headline rather than containment failure?
Dit deel is nog moeilijker te rijmen met het sciencefictionframe.
OpenAI zegt dat de waarborgen die klanten wél krijgen, niet golden in deze evaluatieomgeving. Na het incident bouwde het bedrijf een evaluatie voor infrastructuurcompromittering en vond dat de gewone ChatGPT-omgeving en systeeminstructie de gemeten neiging tot dit gedrag met meer dan honderd keer verminderden.[5]
Het eigen systeem dat acties achteraf beoordeelt, zou veel gevaarlijke handelingen hebben gemarkeerd. En de monitors die meekijken met de gedachtegang van het model — systemen waarin OpenAI al zwaar had geïnvesteerd — draaiden niet op deze evaluaties.
Toen OpenAI zijn huidige monitoring met terugwerkende kracht toepaste, was de conclusie dat security ruim een dag vóórdat de modellen bij Hugging Face binnenkwamen gealarmeerd zou zijn.[5]
Dat is een buitengewoon feit. Lees het nog een keer.
Eén plausibele versie van dit verhaal is dus níet: "AI werd zo capabel dat onze verdediging haar niet meer kon begrijpen of tegenhouden."
Maar wel: "We draaiden ongewoon capabele cyberagents met verminderde waarborgen in een omgeving die uiteindelijk uitgangen had, we schaalden eerdere waarschuwingssignalen onvoldoende op, en we draaiden geen monitoring waarvan we later zelf vaststelden dat die het op tijd had kunnen vangen."
Dat zijn heel verschillende lessen.
OpenAI zegt inmiddels zelf dat zwaktes in hoe het op vroege signalen reageerde en die doorgaf, hebben bijgedragen aan het incident. Het heeft sindsdien de afscherming, de netwerkisolatie, de monitoring en de regels over wie risicovolle proeven mag herstarten of stilleggen aangescherpt.[5]
Die reactie lijkt minder op de mensheid tegenover een onkenbare nieuwe intelligentie. Het lijkt vooral op incident response.
This part is even harder to reconcile with the science-fiction framing.
OpenAI says the production safeguards used for customer-facing systems were not applied to the relevant evaluation environment. After the incident, it created an infrastructure-compromise evaluation and found that the production ChatGPT harness and system prompt reduced the measured propensity for this behaviour by more than 100x.[5]
Its auto-review system, applied retrospectively, would have flagged many dangerous actions. And OpenAI's chain-of-thought monitors - systems in which it had already invested heavily - were not running on these evaluations.
When OpenAI retrospectively applied its current monitoring system, it concluded that security would have been paged more than a day before the models breached Hugging Face.[5]
That is an extraordinary fact.
One plausible version of the story is not: "AI became so capable that our defences could no longer understand or contain it."
It is: "We ran unusually capable cyber agents with reduced safeguards in an environment that ultimately had exploitable paths outward, failed to adequately escalate earlier warning signs, and were not running monitoring we later determined could have caught the incident in time."
Those are very different lessons.
OpenAI itself now says weaknesses in how it responded to and escalated early warning signs contributed to the incident. It has since tightened sandboxing, network isolation, monitoring and the rules governing who can restart or halt high-risk experiments.[5]
That response looks less like humanity confronting an unknowable new intelligence. It looks a lot like incident response.
Wat bewees de inbraak bij Hugging Face dan wél? What did the Hugging Face compromise actually demonstrate?
Hier wordt het incident weer indrukwekkend, en dat wil ik niet wegpoetsen.
Hugging Face reconstrueerde ongeveer 17.600 handelingen van de aanvallers, gegroepeerd in zo'n 6.280 clusters, over de hele campagne. De agents vonden echte kwetsbaarheden, waaronder zero-days. Ze kregen code-uitvoering. Ze bemachtigden credentials. Ze bewogen door productie-infrastructuur.[6]
Dat is echte offensieve capaciteit.
Maar wees precies over wélke capaciteit. De aanval onthulde geen nieuwe categorie hacken. De werkwijze is direct herkenbaar voor iedereen in het vak: verkennen, een exploit bouwen, credentials oogsten, rechten uitbreiden, lateraal bewegen, binnenblijven, gegevens naar buiten brengen, en steeds opnieuw aan vertrouwensgrenzen voelen.
De zero-days zijn oprecht knap. Maar bekwame menselijke onderzoekers vinden ook zero-days. Hugging Face concludeert zelf dat de afzonderlijke zwaktes vertrouwd waren, en dat een capabele menselijke aanvaller dezelfde gebreken had kunnen vinden en uitbuiten.[6]
Wat veranderde was niet de uitvinding van bovenmenselijke techniek. Het was vertrouwd pentest- en red-teamwerk, autonoom uitgevoerd, meedogenloos, en op een schaal die geen menselijk team volhoudt.
De agents deden duizenden handelingen. De meeste liepen nergens op uit. Ze wisselden van kanaal als ze geblokkeerd werden, keerden terug naar eerdere sporen, bewaarden wat bruikbaar was en bleven mogelijkheden aftasten tot er genoeg gewone zwaktes op elkaar aansloten tot een geslaagde keten. Hugging Face wijst volume expliciet aan als het ding dat het verdedigingsprobleem verandert.[6]
Dat onderscheid doet ertoe. Een menselijke pentester wordt moe. Die komt tijd tekort, besluit dat de drieëntwintigste kansarme aftakking geen middag meer waard is, of moet gewoon door naar de volgende klant. Een agent test aftakking drieëntwintig, dan zevenenveertig, dan tweehonderdtwaalf, geeft het bruikbare resultaat door aan een volgend exemplaar en gaat verder.
Dat is potentieel ingrijpend voor cybersecurity. En het is een veel concreter resultaat dan het idee dat de agents een nieuwe collectieve psychologie vertoonden.
Maar er zit nog een variabele verstopt in de diepte van die inbraak: hoe ver je komt als je eenmaal binnen bent.
Een aanvaller die ergens code kan uitvoeren, kan op een strak afgebakende identiteit stuiten en daar stranden. Of hij vindt cloud-metadata, bruikbare credentials, brede rechten en secrets die weer nieuwe omgevingen openen.
Zelfde aanvaller. Heel andere krantenkop.
Hugging Face heeft naderhand precies dat aangepakt: pod-toegang tot cloud-metadata geblokkeerd, de reikwijdte van credentials versmald, meer workloads op workload identity gezet en clusters agressiever geïsoleerd.[6]
Dat doet er enorm toe voordat je van dit ene bedrijf doorredeneert naar "het hele internet". Het internet is niet één beveiligingssysteem. Een overname op ook maar iets dat lijkt op de schaal die Amodei beschrijft, vereist het compromitteren van enorme aantallen verschillende systemen, het overleven van actieve verdedigers, het keer op keer verslaan van onafhankelijke vertrouwensgrenzen, en het binnen blijven nadat credentials zijn ingetrokken en gaten gedicht.
Het incident geeft ons een belangrijk nieuw datapunt over autonome offensieve capaciteit. Het laat die hele keten niet publiekelijk zien.
En er is een veel eenvoudiger getal dat ik zou willen hebben voordat we over een internetovername praten: wat kostte het om bij Hugging Face binnen te komen?
Hoeveel modelaanroepen? Hoeveel tokens? Hoeveel agent-uren? Hoeveel rekenkracht? Wat had de aanval gekost tegen gewone API-prijzen? En hoe groot is de kans op een geslaagde inbraak bij honderd dollar, bij duizend, bij tienduizend, bij honderdduizend?
Noem het de prijs van een inbraak. Die curve doet er voor de komende jaren veel meer toe dan de vraag of een agent zijn eigen mislukking een offer noemde.
Want het echte gevaar is misschien niet één zwerm die Google overneemt. Het zijn misschien duizenden competente geautomatiseerde aanvallers die goedkoop genoeg worden om onafgebroken te richten op miljoenen aanzienlijk slechter beveiligde organisaties.
Op dát punt is het bewijs sterk. OpenAI waarschuwt zelf dat vergelijkbare capaciteiten zich zullen verspreiden, en dat verdedigers zich moeten voorbereiden op AI-gedreven aanvallers die sneller, grootschaliger en beter gecoördineerd opereren dan mensen.[5]
This is where the incident becomes impressive again.
Hugging Face reconstructed approximately 17,600 attacker actions, grouped into roughly 6,280 clusters, across the campaign. The agents discovered genuine vulnerabilities, including zero-days, gained code execution, obtained credentials and moved through production infrastructure.[6]
That is real offensive cyber capability.
But it is important to be precise about what kind of capability it was. The attack did not reveal a new category of hacking. The workflow is instantly recognisable to anyone in offensive security: reconnaissance, exploit development, credential harvesting, privilege escalation, lateral movement, persistence, exfiltration and repeated probing of trust boundaries.
The zero-days are genuinely impressive. But skilled human security researchers discover zero-days too. Hugging Face's own conclusion is that the individual weaknesses were familiar and that a capable human attacker could have found and exploited the same flaws.[6]
What changed was not the invention of superhuman hacking techniques. It was familiar penetration testing and red-team work performed autonomously, relentlessly and at a scale no human team could sustain.
The agents took thousands of actions. Most went nowhere. They switched channels when blocked, returned to earlier leads, preserved useful state and kept testing possibilities until enough ordinary weaknesses lined up into a successful chain. Hugging Face explicitly identifies volume as the thing that changes the defensive problem.[6]
That distinction matters. A human penetration tester eventually gets tired, runs out of time, decides that the twenty-third low-probability branch is not worth another afternoon, or simply has to move on to another client. An agent can test branch twenty-three, branch forty-seven and branch two hundred and twelve, then hand the useful result to another instance and keep going.
That is potentially transformative for cybersecurity. It is also a much more concrete result than the idea that the agents displayed some novel collective psychology.
But there is another variable hiding inside the impressive depth of the compromise: blast radius.
An attacker that gains execution inside one workload may encounter a tightly scoped identity and stop there. Or it may find cloud metadata, useful credentials, broad Kubernetes permissions and secrets that open additional environments.
Same attacker. Very different headline.
Hugging Face itself subsequently blocked pod access to cloud metadata, narrowed credential scope, switched more workloads to workload identity and isolated clusters more aggressively.[6]
This matters enormously before extrapolating from Hugging Face to "the entire internet." The internet is not one security system. A takeover at anything resembling the scale Amodei describes requires compromising huge numbers of heterogeneous systems, surviving active defenders, repeatedly defeating independent trust boundaries and maintaining persistence after credentials are revoked and vulnerabilities are patched.
The Hugging Face incident gives us an important new data point about autonomous offensive capability. It does not publicly demonstrate that chain of capabilities.
And there is a much simpler number I would like before debating internet takeover: how much did it cost to compromise Hugging Face?
How many model calls? How many tokens? How many agent-hours? How much inference? What would the attack have cost at API prices? And what is the probability of successful compromise at $100, $1,000, $10,000 or $100,000 of inference?
Call it cost to compromise. That curve matters far more to near-term cybersecurity than whether an agent described its own failure as a sacrifice.
Because the real danger may not be one swarm taking over Google. It may be thousands of competent automated attackers becoming cheap enough to point continuously at millions of considerably less secure organizations.
On that point, the evidence is strong. OpenAI itself warns that comparable capabilities will diffuse and that defenders need to prepare for AI-enabled attackers operating faster, at larger scale and with better coordination than humans.[5]
Waarom vertellen we het verhaal dan zo? So why are we telling the story this way?
Hier wordt motief moeilijk te scheiden van communicatie.
Ik heb geen enkel bewijs dat OpenAI dit incident wilde, of dat Amodei cynisch een dreiging verzint om Claude aan te prijzen. Geen van beide hoef je te beweren.
Maar er is een onvermijdelijke spanning wanneer de mensen die ons waarschuwen voor buitengewone AI-capaciteit dezelfde mensen zijn die de capabelste AI-systemen ter wereld bouwen.
Kijk eens naar het verhaal zoals het verteld wordt. Onze agents coördineren zonder toestemming. Ze zetten door. Ze vinden zero-days. Ze ontsnappen uit sandboxes. Ze compromitteren echte infrastructuur. En binnenkort bedreigen systemen zoals zij misschien het internet.
Dat is een veiligheidswaarschuwing.
Het is ook een verbluffende demonstratie van wat je hebt gebouwd.
Die twee dingen kunnen tegelijk waar zijn.
Amodei zegt expliciet dat dit incident een van de twee ontwikkelingen was die hem ervan overtuigden dat de industrie het tempo moet temperen. Juist dan is transparantie belangrijker, niet minder.[1]
Als een frontier-baas van een waargenomen incident naar de voorspelling springt dat een opvolger binnen zes tot twaalf maanden het internet zou kunnen overnemen, wil ik niet in de eerste plaats sterkere bijvoeglijke naamwoorden. Ik wil de ontbrekende proeven.
De schaalcurves. De rekenkrachtbudgetten. De containment-tests. De vergelijkingen met wat er zou zijn gebeurd als het anders was opgezet. De onafhankelijke beveiligingsaudit. Het bewijs dat verbindt wat er in juli gebeurde met wat er voor volgend jaar wordt voorspeld.
This is the part where motive becomes difficult to separate from communication.
I have no evidence that OpenAI wanted this incident to happen, or that Amodei is cynically inventing a threat to advertise Claude. There is no need to claim either.
But there is an unavoidable tension when the people warning us about extraordinary AI capability are also the people building the most capable AI systems on earth.
Consider the story: our agents coordinate without permission. They persist. They discover zero-days. They escape sandboxes. They compromise real infrastructure. And soon systems like them may threaten the internet.
That is a safety warning.
It is also an astonishing capability demonstration.
Those two things can be true simultaneously.
Amodei explicitly says the OpenAI-Hugging Face incident was one of two developments that convinced him the industry should slow capability progress. That makes transparency particularly important, not less.[1]
If a frontier CEO moves from an observed incident to a prediction that a successor system may be capable of taking over the internet within 6-12 months, I don't primarily want stronger adjectives. I want the missing experiments.
The scaling curves. The inference budgets. The containment tests. The counterfactuals. The independent security audit. The evidence connecting what happened in July to what is being predicted for next year.
De laatste vraag The final question
En dan is er één vraag die ik hier moeilijk mee kan rijmen.
Wat verwachten Altman en Amodei eigenlijk dat de systemen die ze doelbewust proberen te bouwen, zullen kunnen?
OpenAI zegt expliciet dat zijn missie is te zorgen dat AGI de hele mensheid ten goede komt, en beschrijft zijn werk als voortgaande vooruitgang richting AGI.[7]
Amodei houdt niet van de term AGI. Maar zijn eigen definitie van "krachtige AI" is nauwelijks bescheidener. Slimmer dan een Nobelprijswinnaar in de meeste vakgebieden die ertoe doen. In staat om computers en internet te gebruiken. In staat om uren, dagen of weken zelfstandig door te werken. En te vermenigvuldigen tot miljoenen kopieën die alleen of samen kunnen werken.[8]
Daar zijn we vandaag nog lang niet.
Maar als dát werkelijk de systemen zijn die ze willen bouwen — wat dachten ze dan dat de weg ernaartoe eruit zou zien?
Want duizenden kopieën die notities delen, werk overdragen, softwarekwetsbaarheden uitbuiten en meedogenloos een doel najagen, lijken me ergens onderaan die capaciteitenlijst te staan.
Niet de schokkende openbaring bovenaan.
P.S. — Eén ding om mee te nemen als je met deze techniek werkt in plaats van erover te lezen. Het verschil tussen "onze agents werden gevaarlijk" en "we hadden de monitoring niet aanstaan" is niet academisch. Het is het verschil tussen een probleem waar je niets aan kunt doen en een probleem waar je vanmiddag iets aan kunt doen. Bijna elk verhaal in deze sector wordt op de eerste manier verteld. De meeste zijn het tweede.
And then there is one final question I find difficult to reconcile with all of this:
What exactly do Altman and Amodei expect the systems they are deliberately trying to build to be capable of?
OpenAI explicitly says its mission is to ensure AGI benefits all of humanity and describes its work as continued progress toward AGI.[7]
Amodei dislikes the term AGI, but his own definition of "powerful AI" is hardly more modest: smarter than a Nobel Prize winner across most relevant fields, able to use computers and the internet, capable of autonomous work lasting hours, days or weeks, and scalable to millions of copies that can work independently or collaborate.[8]
We are nowhere near that today.
But if those are genuinely the systems they are trying to build, what exactly did they expect the road there to look like?
Because thousands of copies sharing notes, handing off work, exploiting software vulnerabilities and relentlessly pursuing an objective would seem to be somewhere near the bottom of that capability list.
Not the shocking revelation at the top.
Bronnen Sources
- Dario Amodei, "We Must Pace the Frontier" (September 2026)
- Fortune, "Sam Altman on the burden of leading OpenAI amid AI safety concerns" (15 September 2026)
- Axios, "AI models are becoming unknowable" (4 September 2026)
- METR, "Brief independent investigation of agents' behavior, reasoning and collaboration in the OpenAI / Hugging Face hacking incident" (26 August 2026)
- OpenAI, "The Hugging Face incident and the road ahead" (26 August 2026)
- Hugging Face, "Anatomy of a Frontier Lab Agent Intrusion: A Technical Timeline of the July 2026 Incident"
- OpenAI, "Built to benefit everyone: our plan" (8 June 2026)
- Dario Amodei, "Machines of Loving Grace" (October 2024)
Piet Hein Wokke
Piet Hein Wokke is oprichter van Minerva Digital, dat AI-agents bouwt die complex informatiewerk omzetten in afgerond, controleerbaar werk. Piet Hein Wokke is the founder of Minerva Digital, which builds AI agents that turn complex information work into finished, verifiable output.
Praat met Minerva → Talk to Minerva →